模型文件和布局
[[open-in-colab]]
扩散模型以各种文件类型保存,并以不同的布局组织。Diffusers 将模型权重存储为 Diffusers-multifolder 布局中的 safetensors 文件,并且还支持从 single-file 布局(在扩散生态系统中常用)加载文件(如 safetensors 和 ckpt 文件)。
每种布局都有其自身的优势和使用场景,本指南将向你展示如何加载不同的文件和布局,以及如何进行转换。
文件
PyTorch 模型权重通常使用 Python 的 pickle 工具保存为 ckpt 或 bin 文件。然而,pickle 不安全,被序列化的文件可能包含恶意代码,这些代码在加载时会被执行。鉴于模型共享的流行,这一漏洞是一个严重的担忧。为了解决这一安全问题,开发了 Safetensors 库,作为 pickle 的安全替代方案,它将模型保存为 safetensors 文件。
safetensors
TIP
了解更多关于设计决策以及为什么 safetensor 文件在保存和加载模型权重时更受青睐的内容,可以阅读 Safetensors 审计为真正安全并成为默认选择 博客文章。
Safetensors 是一种安全且快速的文件格式,用于安全地存储和加载张量。Safetensors 限制了头部大小以防止某些类型的攻击,支持懒加载(在分布式设置中非常有用),并且加载速度通常更快。
确保你已经安装了 Safetensors 库。
py
!pip install safetensorsSafetensors 将权重存储在 safetensors 文件中。如果 safetensors 文件可用且安装了 Safetensors 库,Diffusers 会默认加载 safetensors 文件。safetensors 文件可以有两种组织方式:
- Diffusers-多文件夹布局:可能有多个单独的 safetensors 文件,每个管道组件(文本编码器、UNet、VAE)一个,组织在子文件夹中(可以参考 stable-diffusion-v1-5/stable-diffusion-v1-5 仓库作为示例)
- 单文件布局:所有模型权重可能保存在一个文件中(可以参考 WarriorMama777/OrangeMixs 仓库作为示例)
LoRA 文件
LoRA 是一种轻量级适配器,训练速度快且简单,特别适合用于以特定方式或风格生成图像。这些适配器通常存储在 safetensors 文件中,并在像 civitai 这样的模型共享平台上非常流行。
LoRA 通过 [~loaders.StableDiffusionLoraLoaderMixin.load_lora_weights] 方法加载到基础模型中。
py
from diffusers import StableDiffusionXLPipeline
import torch

# base model
pipeline = StableDiffusionXLPipeline.from_pretrained(
    "Lykon/dreamshaper-xl-1-0", torch_dtype=torch.float16, variant="fp16"
).to("cuda")

# download LoRA weights
!wget https://civitai.com/api/download/models/168776 -O blueprintify.safetensors

# load LoRA weights
pipeline.load_lora_weights(".", weight_name="blueprintify.safetensors")
prompt = "bl3uprint, a highly detailed blueprint of the empire state building, explaining how to build all parts, many txt, blueprint grid backdrop"
negative_prompt = "lowres, cropped, worst quality, low quality, normal quality, artifacts, signature, watermark, username, blurry, more than one bridge, bad architecture"

image = pipeline(
    prompt=prompt,
    negative_prompt=negative_prompt,
    generator=torch.manual_seed(0),
).images[0]
image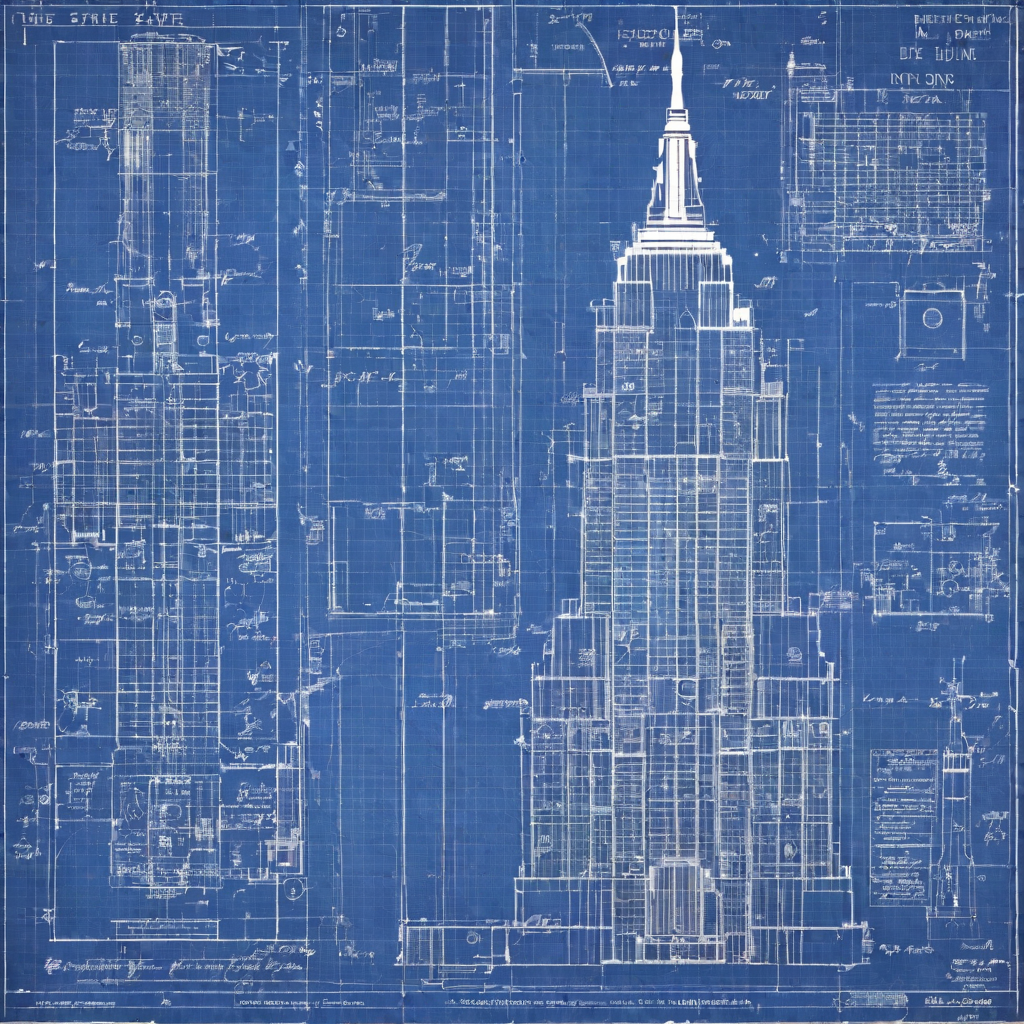
ckpt
WARNING
Pickled 文件可能不安全,因为它们可能被利用来执行恶意代码。建议尽可能使用 safetensors 文件,或者将权重转换为 safetensors 文件。
PyTorch 的 torch.save 函数使用 Python 的 pickle 工具来序列化和保存模型。这些文件保存为 ckpt 文件,包含整个模型的权重。
使用 [~loaders.FromSingleFileMixin.from_single_file] 方法直接加载 ckpt 文件。
py
from diffusers import StableDiffusionPipeline

pipeline = StableDiffusionPipeline.from_single_file(
    "https://huggingface.co/stable-diffusion-v1-5/stable-diffusion-v1-5/blob/main/v1-5-pruned.ckpt"
)
存储布局
模型文件有两种组织方式,一种是 Diffusers 多文件夹布局,另一种是单文件布局。默认情况下使用 Diffusers 多文件夹布局,每个组件文件(文本编码器、UNet、VAE)都存储在单独的子文件夹中。Diffusers 还支持从单文件布局加载模型,其中所有组件都捆绑在一起。
Diffusers 多文件夹布局
Diffusers 多文件夹布局是 Diffusers 的默认存储布局。每个组件(文本编码器、UNet、VAE)的权重都存储在单独的子文件夹中。权重可以存储为 safetensors 或 ckpt 文件。


要从 Diffusers 多文件夹布局加载,使用 [~DiffusionPipeline.from_pretrained] 方法。
py
from diffusers import DiffusionPipeline

pipeline = DiffusionPipeline.from_pretrained(
    "stabilityai/stable-diffusion-xl-base-1.0",
    torch_dtype=torch.float16,
    variant="fp16",
    use_safetensors=True,
).to("cuda")
使用 Diffusers-multifolder 布局的好处包括:
可以更快地单独或并行加载每个组件文件。
由于你只需加载所需的组件,因此可以减少内存使用。例如,像 SDXL Turbo、SDXL Lightning 和 Hyper-SD 这样的模型,除了 UNet 之外,其他组件都是相同的。你可以使用 [
~DiffusionPipeline.from_pipe] 方法重用它们的共享组件,而不会消耗额外的内存(请参阅 重用管道 指南),并且只需加载 UNet。这样,你就不需要下载冗余的组件,从而避免不必要的内存使用。pyimport torch from diffusers import StableDiffusionXLPipeline, UNet2DConditionModel, EulerDiscreteScheduler # download one model sdxl_pipeline = StableDiffusionXLPipeline.from_pretrained( "stabilityai/stable-diffusion-xl-base-1.0", torch_dtype=torch.float16, variant="fp16", use_safetensors=True, ).to("cuda") # switch UNet for another model unet = UNet2DConditionModel.from_pretrained( "stabilityai/sdxl-turbo", subfolder="unet", torch_dtype=torch.float16, variant="fp16", use_safetensors=True ) # reuse all the same components in new model except for the UNet turbo_pipeline = StableDiffusionXLPipeline.from_pipe( sdxl_pipeline, unet=unet, ).to("cuda") turbo_pipeline.scheduler = EulerDiscreteScheduler.from_config( turbo_pipeline.scheduler.config, timestep+spacing="trailing" ) image = turbo_pipeline( "an astronaut riding a unicorn on mars", num_inference_steps=1, guidance_scale=0.0, ).images[0] image减少了存储需求,因为如果一个组件(如 SDXL VAE)在多个模型中共享,你只需要下载和存储一份,而不需要多次下载和存储。对于 10 个 SDXL 模型,这可以节省约 3.5GB 的存储空间。对于像 PixArt Sigma 这样的新模型,存储节省更多,仅 文本编码器 就有约 19GB!
可以灵活地用更新或更好的版本替换模型中的组件。
pyfrom diffusers import DiffusionPipeline, AutoencoderKL vae = AutoencoderKL.from_pretrained("madebyollin/sdxl-vae-fp16-fix", torch_dtype=torch.float16, use_safetensors=True) pipeline = DiffusionPipeline.from_pretrained( "stabilityai/stable-diffusion-xl-base-1.0", vae=vae, torch_dtype=torch.float16, variant="fp16", use_safetensors=True, ).to("cuda")更多关于模型组件的可见性和信息,这些组件存储在每个组件子文件夹中的 config.json 文件中。
单文件布局
单文件布局将所有模型权重存储在一个文件中。所有模型组件(文本编码器、UNet、VAE)的权重都集中存储,而不是分别存储在子文件夹中。这可以是一个 safetensors 文件或 ckpt 文件。

要从单文件布局加载,使用 [~loaders.FromSingleFileMixin.from_single_file] 方法。
py
import torch
from diffusers import StableDiffusionXLPipeline

pipeline = StableDiffusionXLPipeline.from_single_file(
    "https://huggingface.co/stabilityai/stable-diffusion-xl-base-1.0/blob/main/sd_xl_base_1.0.safetensors",
    torch_dtype=torch.float16,
    variant="fp16",
    use_safetensors=True,
).to("cuda")
使用单文件布局的好处包括:
- 与 ComfyUI 或 Automatic1111 等扩散接口的兼容性更好,这些接口通常使用单文件布局。
- 单个文件更容易管理(下载和分享)。
转换布局和文件
Diffusers 提供了许多脚本和方法来转换存储布局和文件格式,以支持更广泛的扩散生态系统。
查看 diffusers/scripts 集合,找到适合你转换需求的脚本。
TIP
以 "to_diffusers" 结尾的脚本表示将模型转换为 Diffusers-多文件夹布局。每个脚本都有自己的特定参数集来配置转换,因此请确保检查可用的参数!
例如,要将存储在 Diffusers-多文件夹布局中的 Stable Diffusion XL 模型转换为单文件布局,可以运行 convert_diffusers_to_original_sdxl.py 脚本。提供要转换的模型的路径,以及保存转换后模型的路径。你可以选择是否将模型保存为 safetensors 文件,以及是否以半精度保存模型。
bash
python convert_diffusers_to_original_sdxl.py --model_path path/to/model/to/convert --checkpoint_path path/to/save/model/to --use_safetensors你也可以使用 [~DiffusionPipeline.save_pretrained] 方法将模型保存为 Diffusers 多文件夹布局。如果目录尚不存在,此方法会为你创建一个目录,并且默认情况下会将文件保存为 safetensors 格式。
py
from diffusers import StableDiffusionXLPipeline

pipeline = StableDiffusionXLPipeline.from_single_file(
    "https://huggingface.co/stabilityai/stable-diffusion-xl-base-1.0/blob/main/sd_xl_base_1.0.safetensors",
)
pipeline.save_pretrained()
最后,还有一些 Spaces,如 SD To Diffusers 和 SD-XL To Diffusers,提供了更用户友好的界面,用于将模型转换为 Diffusers 多文件布局。这是最简单和最方便的转换选项,它会在你的模型仓库中打开一个包含转换后文件的 PR。然而,这个选项不如运行脚本可靠,对于更复杂的模型,Space 可能会失败。
单文件布局的使用
现在你已经熟悉了 Diffusers 多文件布局和单文件布局之间的差异,本节将向你展示如何加载模型和管道组件,自定义加载配置选项,以及使用 [~loaders.FromSingleFileMixin.from_single_file] 方法加载本地文件。
加载管道或模型
将管道或模型的文件路径传递给 [~loaders.FromSingleFileMixin.from_single_file] 方法以加载它。
通过将组件直接传递给 [~loaders.FromSingleFileMixin.from_single_file] 方法来自定义管道中的组件。例如,你可以在管道中使用不同的调度器。
py
from diffusers import StableDiffusionXLPipeline, DDIMScheduler

ckpt_path = "https://huggingface.co/stabilityai/stable-diffusion-xl-base-1.0/blob/main/sd_xl_base_1.0_0.9vae.safetensors"
scheduler = DDIMScheduler()
pipeline = StableDiffusionXLPipeline.from_single_file(ckpt_path, scheduler=scheduler)
或者你可以在管道中使用一个 ControlNet 模型。
py
from diffusers import StableDiffusionControlNetPipeline, ControlNetModel

ckpt_path = "https://huggingface.co/stable-diffusion-v1-5/stable-diffusion-v1-5/blob/main/v1-5-pruned-emaonly.safetensors"
controlnet = ControlNetModel.from_pretrained("lllyasviel/control_v11p_sd15_canny")
pipeline = StableDiffusionControlNetPipeline.from_single_file(ckpt_path, controlnet=controlnet)
自定义配置选项
模型有一个配置文件,用于定义其属性,例如 UNet 中的输入数量。管道的配置选项可以在管道类中找到。例如,如果你查看 [StableDiffusionXLInstructPix2PixPipeline] 类,其中有一个选项是通过 is_cosxl_edit 参数来缩放图像潜变量。
这些配置文件可以在模型的 Hub 仓库或其他配置文件的来源位置找到(例如,GitHub 仓库或你设备上的本地路径)。
虽然配置文件指定了管道或模型的默认参数,但你可以通过直接向 [~loaders.FromSingleFileMixin.from_single_file] 方法提供参数来覆盖它们。任何由模型或管道类支持的参数都可以通过这种方式进行配置。
本地文件
在 Diffusers>=v0.28.0 中,[~loaders.FromSingleFileMixin.from_single_file] 方法尝试通过从检查点文件中的键推断模型类型来配置管道或模型。推断出的模型类型用于确定在 Hugging Face Hub 上配置模型或管道的适当模型仓库。
例如,任何基于 Stable Diffusion XL 基础模型的单文件检查点将使用 stabilityai/stable-diffusion-xl-base-1.0 模型仓库来配置管道。
但如果你在互联网访问受限的环境中工作,你应该使用 [~huggingface_hub.snapshot_download] 函数下载配置文件,使用 [~huggingface_hub.hf_hub_download] 函数下载模型检查点。默认情况下,这些文件会下载到 Hugging Face Hub 缓存目录,但你可以使用 local_dir 参数指定一个首选目录来下载文件。
将配置和检查点路径传递给 [~loaders.FromSingleFileMixin.from_single_file] 方法以本地加载。
不使用符号链接的本地文件
TIP
在 huggingface_hub>=v0.23.0 中,local_dir_use_symlinks 参数对于 [~huggingface_hub.hf_hub_download] 和 [~huggingface_hub.snapshot_download] 函数不是必需的。
[~loaders.FromSingleFileMixin.from_single_file] 方法依赖于 huggingface_hub 的缓存机制来获取和存储模型和管道的检查点和配置文件。如果你正在使用不支持符号链接的文件系统,你应该首先将检查点文件下载到本地目录,并在 [~huggingface_hub.hf_hub_download] 函数和 [~huggingface_hub.snapshot_download] 函数中使用 local_dir_use_symlink=False 参数来禁用符号链接。
python
from huggingface_hub import hf_hub_download, snapshot_download

my_local_checkpoint_path = hf_hub_download(
    repo_id="segmind/SSD-1B",
    filename="SSD-1B.safetensors"
    local_dir="my_local_checkpoints",
    local_dir_use_symlinks=False
)
print("My local checkpoint: ", my_local_checkpoint_path)

my_local_config_path = snapshot_download(
    repo_id="segmind/SSD-1B",
    allow_patterns=["*.json", "**/*.json", "*.txt", "**/*.txt"]
    local_dir_use_symlinks=False,
)
print("My local config: ", my_local_config_path)
然后你可以将本地路径传递给 pretrained_model_link_or_path 和 config 参数。
python
pipeline = StableDiffusionXLPipeline.from_single_file(my_local_checkpoint_path, config=my_local_config_path, local_files_only=True)